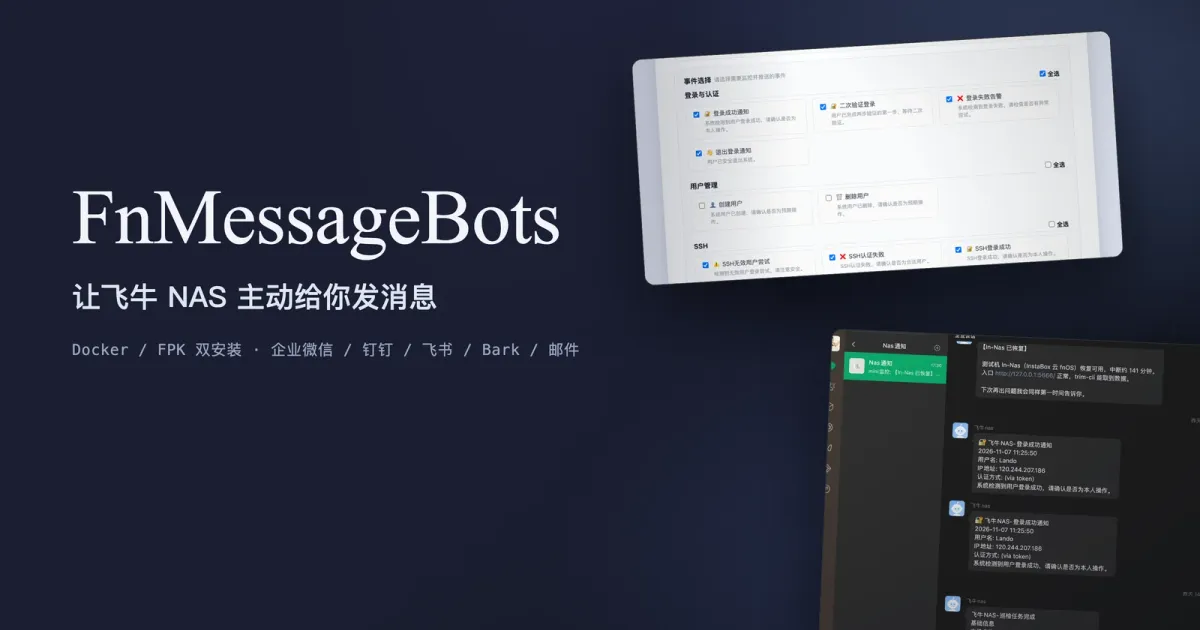
飞牛 NAS 上没有事件总线,只有一个 SQLite 日志库。要把「谁登录了、哪块盘醒了、哪个容器崩了」变成手机上的一条消息,只能自己搭一条管道。
单进程 Python,57 个模块约 2.3 万行,28 个测试文件、365 个用例。应用中心 + Docker 累计下载 7 万+,约一千个稳定在用的用户。
这篇把它拆开:数据从哪来、怎么变成一条消息、失败时怎么兜,以及路上踩过的坑。
一、先说结论:环境与代码规模
| 项 | 值 |
|---|---|
| 运行时 | Python ≥ 3.9(官方镜像 python:3.11-slim) |
| 平台 | fnOS(os_min_version = 1.1.3100)、任意 Docker 主机(amd64 / arm64) |
| 代码 | src/ 57 个 .py,约 23,170 行 |
| 测试 | 28 个测试文件,365 个用例(含 123 个 subtest) |
| 依赖 | requests、psutil、Flask 等常规包;FPK 版在 NAS 上建 venv |
| 状态目录 | data/cursor/(游标、outbox)、data/logs/(按天切、留 7 天)、config/config.json |
src/├── main.py # 装配、信号、热加载、批汇总刷盘线程├── monitor/│ ├── db_log_poller.py # 主日志库轮询(游标 = 自增 id)│ ├── ssh_journal_poller.py # journalctl 采 SSH(新版主库没有 Sshd 记录)│ ├── docker_events_poller.py # docker unix socket 事件流│ ├── media_db_poller.py / music_db_poller.py / photo_db_poller.py│ ├── scheduler_db_poller.py / backup_db_poller.py / trim_activity_poller.py│ ├── event_processor.py # 事件 → 汇总、合并窗口、处理函数注册表│ ├── batch_dedupe.py # 批内指纹去重(按源定制)│ └── nas_patrol.py / wan_ip_monitor.py├── notifier/ # 10 个渠道 + 统一分发 + 300 秒去重├── web/ # Flask 配置页、鉴权、数据源只读自检└── utils/notification_outbox.py # 落盘待发队列(SQLite)二、四条约束决定了全部设计
| 约束 | 直接后果 |
|---|---|
| 只有一个 SQLite 库,没有推送接口 | 只能轮询;游标必须用自增 id,不能用时间戳 |
| 用户不会给日志机器人 root | 默认 FnMessageBot 应用账号;读不到的源靠 ACL 通知,不靠提权 |
| 装在 i3-8100T / 15G 这类小主机上 | 单进程多线程,不引 Redis / MQ;状态全是文件 |
| 通知工具一旦吵人就会被卸载 | 去重、合并、勿扰、汇总不是功能,是生存条件 |
三、启动顺序与线程模型
Application.initialize() 的顺序是有讲究的:
self.config = Config()                    # env 覆盖 + config.json
init_push_stats(self.config.cursor_dir)   # 推送统计(Web 页上的数字)
has_webhook = any(10 个渠道参数)           # 没配渠道 → 只起 Web 配置页
self.notifier = UnifiedNotifier(config)
self.event_processor = EventProcessor(notifier, config)
self.log_poller = self._build_log_poller()
self._sync_optional_pollers()             # 按勾选起 0~8 个数据源线程
self._register_db_event_handlers()        # eventId → handler 映射
# 再 start() 各 poller、起 UnifiedPollBatchFlush 线程、巡检线程、Flask两个刻意的顺序:没配渠道就不轮询(否则用户装完还没配企微,后台已经在读库算去重,纯浪费);可选数据源按需起线程(8 个源各自一套轮询 + 游标,没勾就一个线程都不起)。
线程之间没有共享可变状态的中心:每个 poller 只写自己的游标,事件以不可变字典往下传。
| 线程 | 职责 | 周期 |
|---|---|---|
DBLogPoller | 主日志库 | 5 秒 |
| 各可选 poller | docker / 影视 / 音乐 / 相册 / scheduler / 备份 / trim-activity / SSH | 各自开关 |
UnifiedPollBatchFlush | 把攒着的批汇总刷出去 | 事件驱动 |
nas_patrol | CPU / 温度 / SMART / 容量 | 用户设的 Cron |
wan_ip_monitor | 外网 IP 变化 | 600 秒 |
四、采集:为什么游标是 id,不是时间
def _run_loop(self):
    last_id = None
    while self.running:
        if last_id is None:                       # 首次启动
            last_id = self._get_max_log_id()      # SELECT COALESCE(MAX(id),0) FROM log
            self._write_last_id(last_id)          # data/cursor/db_poller_cursor.txt
last_id = self._poll_once(last_id)第一次必须成功取到 MAX(id) 才继续;取不到就循环重试,绝不猜一个游标开始读——猜低会被历史消息刷屏,猜高会永远收不到新事件。
取数语句只有一条,靠 id ASC 保证顺序即发生顺序:
SELECT id, serviceId, uid, uname, logtime, loglevel, eventId, parameter, category
FROM log WHERE id > ? ORDER BY id ASC
用 id 而不是 logtime,是因为旧版飞牛的 logtime 有偏移(这就是后来 LOGTIME_DISPLAY_OFFSET_SECONDS 存在的原因):拿时间戳做游标,夏令时/时区一变就漏推或重推。
连接一律走 connect_readonly_with_fallback() 打开只读,因为这是别人的数据库——我的进程不能持有写锁把飞牛自己的日志服务卡住。
采到的行要做四件事,顺序不能换:eventId 映射成内部类型 → 特例修正(SshdLoginAuthFail + uname=invalid 拆成 SSH_INVALID_USER,因为飞牛那边一个 eventId 混了两种语义)→ 过滤(勾选清单、SSH 来源黑白名单)→ _parse_parameter() 解析 JSON 并补三个溯源字段 _source / _source_cursor / _source_event_id。没有这三个字段,后面所有去重都失效。
五、汇聚:一轮轮询只发一条
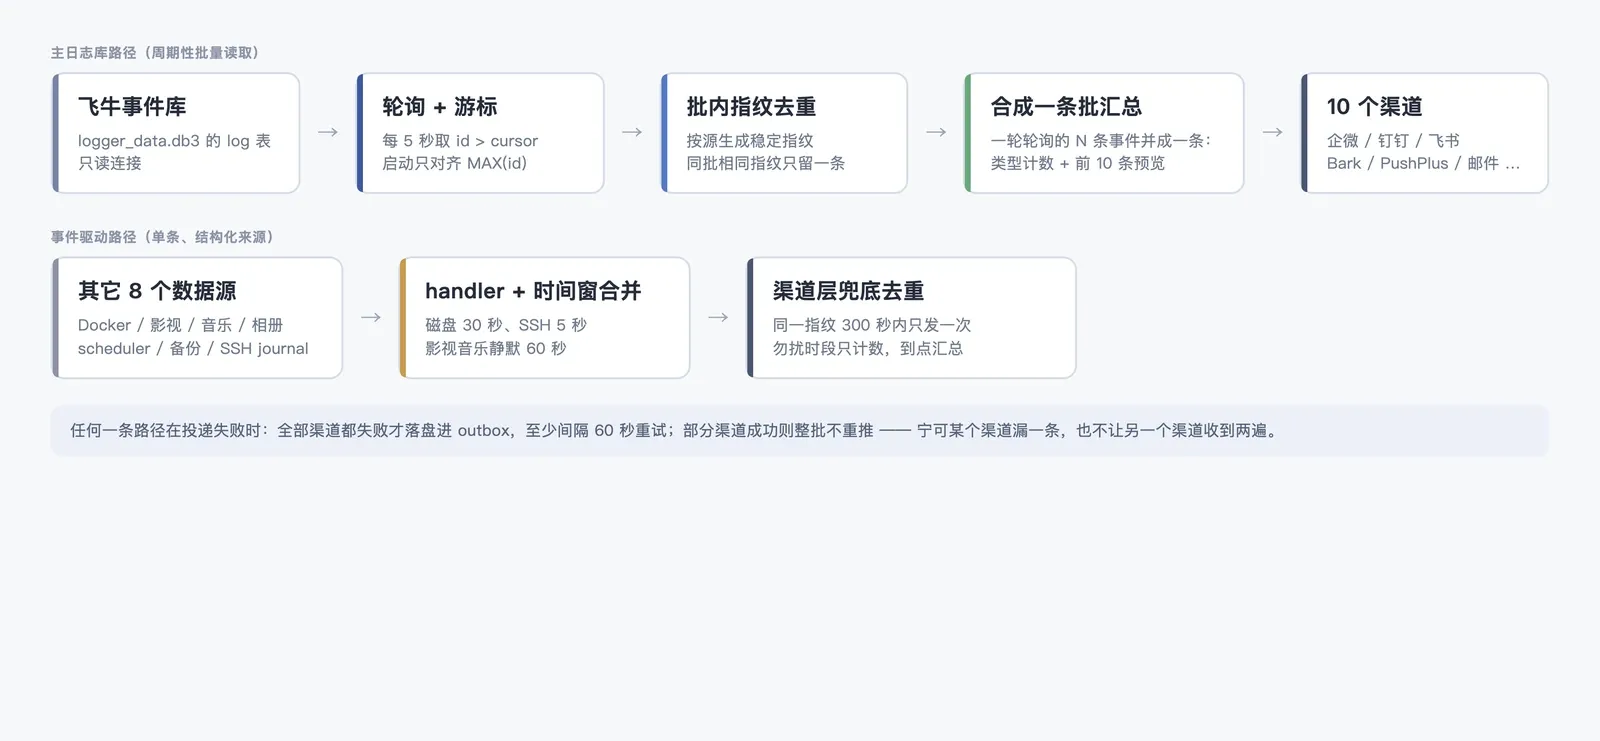
这是全项目最重要的决定。一轮 poll 拿到的 N 条事件不会发 N 条消息,而是合成一条 POLL_BATCH_SUMMARY:
batch_events = dedupe_poll_batch_items(batch_events)      # 批内指纹去重
summary_event_data = {
  "count": len(batch_events),
  "by_type": {"SSH_AUTH_FAILED": 1, ...},                 # 按类型计数
  "items": preview_items[:10],                            # 前 10 条摘要
  "grouped_events": grouped_events,                       # 勿扰汇总要用
  "_source_key": md5(拼接 source:cursor),                 # 渠道层去重用
}
self.notifier.send_notification(event_type="POLL_BATCH_SUMMARY", ...)为什么:企业微信群机器人每分钟 20 条上限。断电恢复、批量入库、被爆破,都可能在一轮里产生几十条。逐条发的结局不是「更及时」,而是被限流静默丢弃——丢掉的恰好是最要紧那条。
原始日志仍然逐条写进本地存储(_store_notification_log),所以「合并不丢信息」:消息里是梗概,查历史去库里查。
六、三层去重,各挡一种重复
去重不是「一个窗口」,是三层,每层解决不同来源的重复:
| 层 | 实现 | 挡的是什么 |
|---|---|---|
| L1 批内指纹 | batch_dedupe.fingerprint_poll_batch_item() | 双线程入队、刷盘竞态的重复 |
| L2 时间窗合并 | 磁盘 30s / SSH 5s / 影视音乐静默 60s | 同一件事连续触发(反复唤醒、爆破、批量入库) |
| L3 渠道层 300s | _is_duplicate() | 跨轮询、跨数据源的兜底重复 |
L1 的指纹按源定制,Docker 那条必须带纳秒:
if source == "docker":
    # cid + action + timeNano;漏掉纳秒会把同容器短时间两次同类事件误合并
    return f"docker:{event_type}:{cid}:{action}:{engine_time_nano}"
row_id = item.get("row_id")
return f"{source}:{event_type}:row:{row_id}"
L3 就是一个带锁的字典加时间戳:
def _is_duplicate(self, fingerprint: str) -> bool:
    with self._dedup_lock:
        if fingerprint in self.sent_events:
            if time.time() - self.sent_events[fingerprint] < self.dedup_window:  # 300
                return True
            del self.sent_events[fingerprint]
    return False
七、失败语义:投递成功之后才推进游标
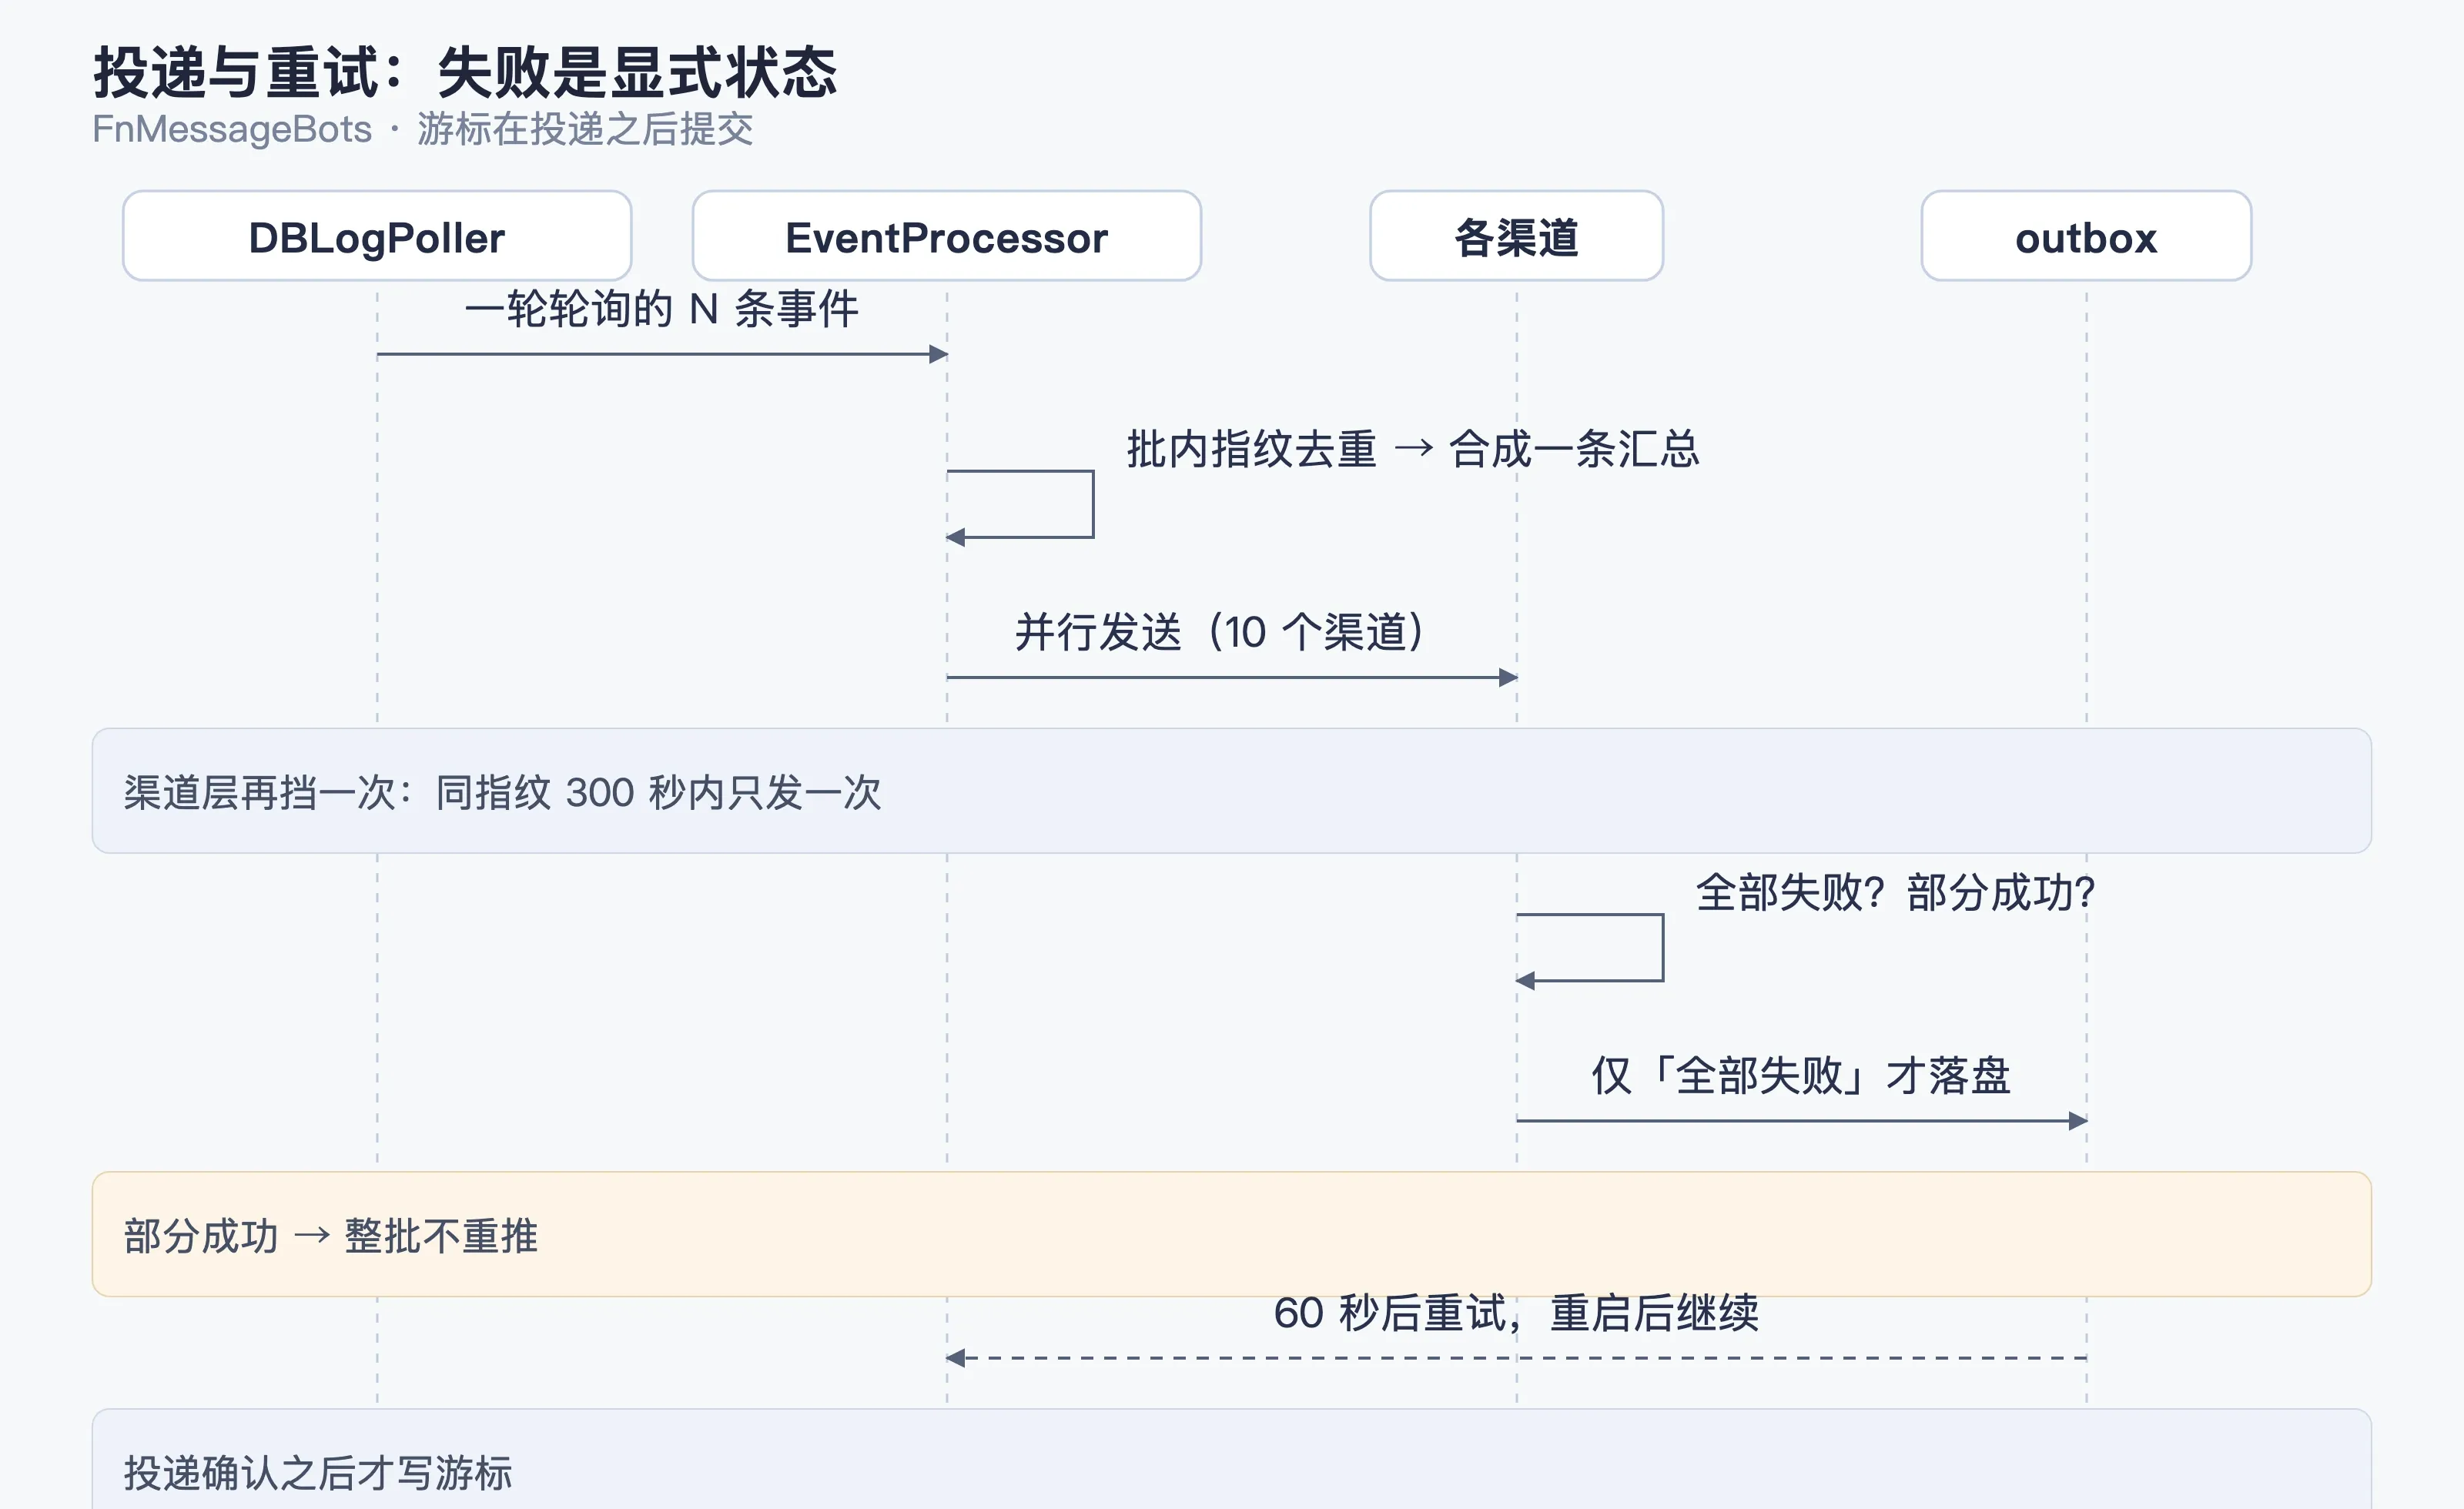
三个失败场景,三套语义,都在 _poll_once 末尾这几行里:
if self.batch_handler and batch_events and batch_delivery_failed:
    self._batch_fail_count += 1
    if persistence_failed or self._batch_fail_count < self.BATCH_MAX_ATTEMPTS:
        return last_id          # 不推进游标 → 下一轮重来
    self.logger.warning("批量处理连续失败 %s 次,放弃本批", self._batch_fail_count)
self._write_last_id(rows[-1]["id"]) # 只有走到这儿才提交游标OutboxWriteError(队列都没写进去)永不推进游标:宁可下次重复读,也不能让事件凭空消失;- 普通异常重试
BATCH_MAX_ATTEMPTS次后放弃并推进:一条能让处理器崩掉的毒事件不该卡死整条管道; - 推送全部渠道失败 → 落进 outbox,
RETRY_SECONDS = 60重试;部分渠道成功 → 整批不重推(重复消息比漏消息更容易让人卸载)。
outbox 不是内存 list,是真队列:
self.path = directory / "notification_outbox.db"        # chmod 0600
CREATE TABLE state       (name TEXT PRIMARY KEY, payload TEXT NOT NULL)
CREATE TABLE poll_events (id   TEXT PRIMARY KEY, payload TEXT NOT NULL)
PRAGMA synchronous=FULL
BEGIN IMMEDIATE
勿扰时段也不丢事件:计数写进 state 表,到点合成一条;并且返回 success=True——否则上游会以为失败、反复重试「故意不发」;指纹 receipt 存 7 天,避免晨间汇总重复计数。
八、踩坑记录
这些不是编的,逐条对应仓库里的修复提交。
| 现象 | 根因 | 修法 |
|---|---|---|
| 勿扰时段整体偏 8 小时,白天不推、半夜推送 | 容器默认 TZ=UTC,勿扰按本地时间比较 | Dockerfile 与 compose 默认 TZ=Asia/Shanghai,另给 LOGTIME_DISPLAY_OFFSET_SECONDS 处理旧库时间偏移 |
| 在飞牛应用中心(iframe)里滚到一半页面白屏 | 事件列表外层再套一个滚动容器,iframe 里嵌套滚动触发重绘 bug | 去掉内层滚动,让 iframe 自己滚 |
| 手机浏览器登录后又弹回密码页 | 移动端对会话 cookie 的策略差异,会话没被带上 | 会话校验放宽到「带上就认」,不再依赖单一 cookie 属性 |
| 数据源自检显示正常,实际读不到数据 | 只读探测只执行 SELECT 1,库半损坏也返回成功 | 探测改为真正读业务表 + 校验内容,失败时给 ACL 命令 |
| 不同数据源的事件互相顶掉,偶尔漏推 | 去重键只用 row_id,跨源撞号 | 指纹改为 source:type:row_id,按源隔离 |
| 覆盖安装后配置和主题被重置 | 升级脚本无条件写默认配置 | 只在新装时写默认值,覆盖安装保留 config.json |
| 空配置时音乐库读不到 | 没配置路径时没有回退标准路径 | 回退到标准路径并提示 ACL 命令 |
| CI 上 SSH 相关测试静默跳过 | 没有 systemd 的环境探测失败,用例被 skip | 探测注入 mock,测试不再依赖宿主环境 |
另外两个不是 bug 但值得记的设计:容器健康检查要验两件事(进程在 + /healthz 通),只 pgrep 会漏掉「进程活着但服务卡死」;健康检查不走代理,否则代理返回的 200 会把本地后台故障盖住:
if ! pgrep -f "python.*src/main.py" > /dev/null; then echo "Python进程不存在"; exit 1; fi
python - <<'PY'
from urllib.request import ProxyHandler, build_opener     # 显式禁用代理
host = {"0.0.0.0": "127.0.0.1", "::": "::1"}.get(host, host)
PY
九、配置项与鉴权
配置只有一个手写源 config/config.json,环境变量优先:
| 变量 | 作用 |
|---|---|
LOGGER_DB_PATH / LOGGER_POLL_INTERVAL | 库路径 / 轮询间隔(默认 5s) |
DEDUP_WINDOW | 渠道层去重窗口(默认 300s) |
MONITOR_EVENTS | 勾选的事件清单 |
HTTP_TIMEOUT / HTTP_POOL_SIZE / HTTP_RETRY_COUNT | 渠道 HTTP 参数 |
UI_PORT / UI_HOST / FNMB_WEB_PASSWORD | 配置页端口与初始密码 |
FNMB_TRUSTED_PROXIES | 只有这些 IP/CIDR 才信任 X-Forwarded-For |
LOGTIME_DISPLAY_OFFSET_SECONDS | 旧库时间偏移补偿 |
实现上有个细节:谁被环境变量设过就记进 _env_set_keys,读配置文件时 env_skip() 直接跳过这些键。所以「env 里设过的东西 UI 改不动」是设计,不是 bug。
鉴权三层:首次用启动日志里的一次性初始化码设密码(否则同网段谁都能先设)→ 只存 PBKDF2-HMAC-SHA256(ITERATIONS = 100000)的盐与哈希 → 内存会话,空闲 900 秒过期,改密全量作废。
十、两种发行
Docker:python:3.11-slim,只装四个系统包——procps(健康检查 pgrep)、nut-client(读 UPS)、smartmontools(读 SMART)、systemd(提供 journalctl 采 SSH)。HEALTHCHECK --interval=30s --timeout=10s --retries=3 --start-period=40s,amd64/arm64 分架构构建后合并 digest。
FPK:manifest 里 platform = all、checkport = false(端口交给向导);install_callback 干四件事——首次安装才拷默认配置、向导密码只写盐+哈希并 chmod 600、建 venv 装依赖(NAS 部分卷不支持符号链接,--copies 优先、失败回退 pip install --target)、失败时给 Docker 版兜底地址。覆盖安装保留原端口与密码。
十一、取舍与已知限制
| 选择 | 替代方案 | 为什么不用 |
|---|---|---|
| 轮询 SQLite | inotify / journalctl -f | 主库没有事件流;inotify 只知道「文件被写」,拿不到结构化字段 |
| 一轮合并一条 | 逐条实时推送 | 撞渠道限流,会把最要紧那条一起丢掉 |
| 单进程多线程 | 采集/投递拆两个容器 | 多一个部署单元,故障半径反而变大 |
| 自写 SQLite outbox | Celery / Redis | 用户机器上多一个常驻服务是负担 |
| 固定 60 秒重试 | 指数退避 | 事件通知价值随时间衰减,5 分钟后补发不如不发 |
| 默认最小权限 | 一律 root | 装在别人 NAS 上,不能因为我的 bug 弄坏他的系统 |
已知限制:5 秒是延迟下限;不补发(手机离线两小时不会补,要去日志库查);outbox 单写者(一天几百条够用,高吞吐不合适);事件清单跟飞牛版本绑定——eventId 改名或表结构变就得适配,这是本项目主要维护成本。
怎么拿到
- 应用中心搜「日志推送」,或 GitHub Release 下载
.fpk - Docker:
sunanang/fn-message-bots:latest(amd64 / arm64) - 源码(MIT):github.com/Sunanang/FNMessageBots
安装、事件怎么勾、权限怎么给:FnMessageBots:让 NAS 主动给你发消息